

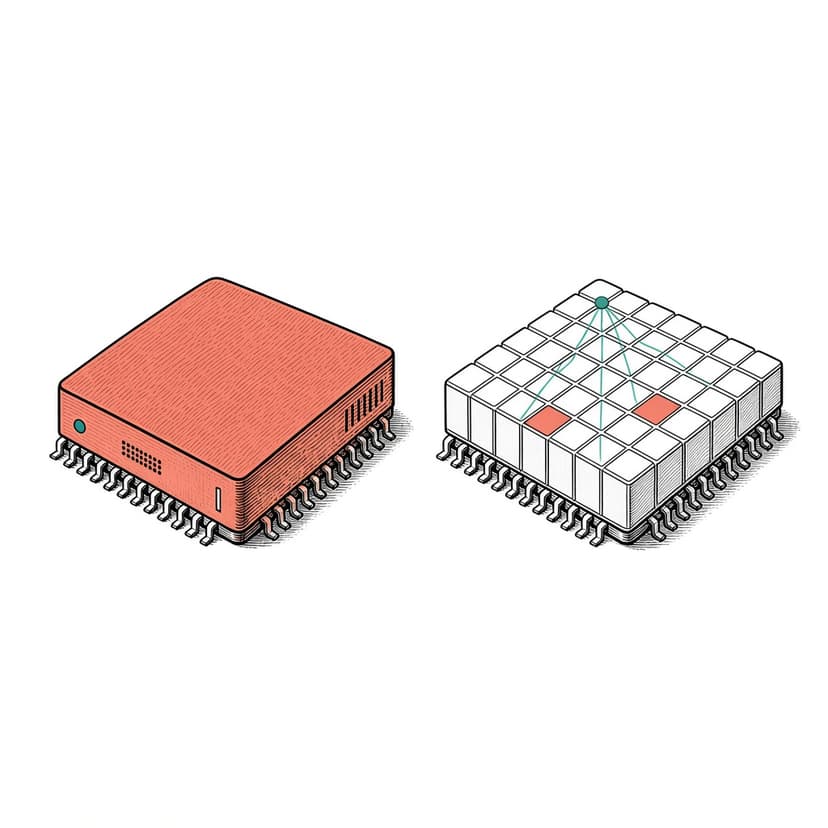

Für diesen Vergleich nutzen wir Qwen3.8 27B und DeepSeek V4.1 Flash.
Das Qwen Modell ist ein Dense Model, und der Traum fürs Self Hosting. Das DeepSeek Modell ist der Traum der Inferenzanbieter, und ein Mixture of Experts Modell (MoE).
Beide erreichen vergleichbare Benchmarkwerte (obwohl DeepSeek insgesamt deutlich besser abschneidet). Beide sind multimodal. Beide sind Open Weight.
Aber DeepSeek V4.1 Flash braucht deutlich mehr Ressourcen zum Betrieb, ist smarter, und kostet auf Inferenzplattformen trotzdem weniger. Wie ist das möglich?
Das Preisparadox
Auf Tensorix, bei fp8 Präzision, gleicher Anbieter und gleiche Präzision:
| Qwen3.8 27B | DeepSeek V4.1 Flash | |
|---|---|---|
| Parameter gesamt | 27B | 552B |
| Aktiv pro Token | 27B | 8B Prefill / 16B Decode |
| Input | €0,359/M | €0,449/M |
| Output | €2,154/M | €1,346/M |
DeepSeek ist viel größer, aber seine Output Tokens kosten 1,6× weniger als bei Qwen. Warum?
Dense: jeder Parameter, jeder Token
Jeder Parameter nimmt an jedem Token teil. 27B Parameter bedeuten 27B Multiply Accumulate Operationen pro Token, bei jedem Token. Die Rechenlast ist gleichmäßig und vorhersehbar, lässt sich aber nicht über Geräte aufteilen. Eine Dense Layer ist eine Matrixmultiplikation.
MoE: der Großteil des Modells sitzt untätig da
Die Feed Forward Schichten werden durch ein Set von Expertennetzwerken plus einen Router ersetzt. Der Router wählt pro Token eine kleine Teilmenge der Experten. DeepSeek V4.1 Flash hat insgesamt 552B Parameter und aktiviert 8B beim Prefill und 16B beim Decode. Die anderen ~536B liegen im Speicher und tun für diesen Token nichts.
Das gibt MoE zwei Vorteile. Erstens weniger Rechenaufwand pro Token: 16B aktiv gegen Qwens 27B. Zweitens lassen sich die Experten über GPUs verteilen, sodass ein großes MoE parallelisiert, wie es ein Dense Model derselben Größe nicht kann.
Der Haken ist der Speicher
Der Preis ist allerdings Speicher. Alle 552B Parameter müssen im Speicher liegen, bevor das Modell irgendetwas ausliefert. Bei fp8 sind das grob 550GB Gewichte. Qwen3.8 27B bei fp8 sind etwa 27GB und passen mit Quantisierung auf eine 24GB GPU.
Einmal geladen, sind die Gewichte read only und werden über Requests geteilt, die Fixkosten zahlt man also nur einmal. Was mit dem Traffic skaliert, sind der KV Cache und die Rechenlast. Ein großes MoE kann seine Experten über viele GPUs verteilen, sodass ein Anbieter mit der Hardware viele Requests gleichzeitig bedienen kann. Ein 27B Dense Model lässt sich so nicht aufteilen, weil es auf einem Gerät läuft und die Parallelität durch dieses Gerät begrenzt ist.
Das heißt: Wer schon die große Hardware hat, kann mit dem MoE Modell viele Requests schnell bedienen. Wer schwächere Hardware hat, kann das insgesamt kleinere Modell betreiben, aber nicht so stark parallelisieren.
Was gewinnt also?
MoE ist günstig im Betrieb bei Scale und teuer im Self Hosting. Dense ist das Gegenteil.
Wir hoffen, das hilft, ein Gefühl für die Unterschiede in LLM Architekturen zu bekommen. Mehr Kontext zu den Modellen selbst gibt es in unseren Artikeln zu KI Sprachmodell Beispielen und den Vorteilen von On Premise KI.
Über Dentro
Wir helfen europäischen Unternehmen seit 3 Jahren bei allem rund um KI. Wenn Sie Ideen haben, KI in Ihrem Unternehmen umzusetzen, schreiben Sie uns oder senden Sie uns eine Email an office@dentroai.com. Wir antworten gerne.